LLM을 직접 평가하는 시스템을 만들었다 — 1TB 모델과 20GB 모델의 차이
공개 벤치마크로는 내 용도에 뭐가 맞는지 알 수 없었다. 로컬 모델과 상용 API를 같은 문제로 채점하는 시스템을 만들고 얻은 결과를 정리했다.
로컬에서 LLM을 여러 개 돌리다 보면 결정해야 할 게 생긴다. 어떤 모델을 상시로 띄워둘 것인가.
VRAM은 한정돼 있고 모델은 계속 나온다. 공개 벤치마크 순위표를 봐도 답이 안 나왔다. 순위가 높은 모델이 내가 시키는 일을 잘한다는 보장이 없기 때문이다.
그래서 직접 평가 시스템을 만들었다.
공개 벤치마크로는 안 되는 이유
공개 벤치마크는 잘 만들어져 있다. 문제는 내 용도와 맞는지 알 수 없다는 것이다.
- 내가 시키는 일은 대부분 한국어다. 영어 벤치마크 점수가 한국어 성능을 보장하지 않는다
- 나는 모델에게 도구를 호출하고 여러 단계를 수행하게 시킨다. 단답형 정답률과는 다른 능력이다
- 출력 형식을 지켜야 하는 경우가 많다. JSON을 요구했는데 설명을 붙이면 파이프라인이 깨진다
- 양자화 버전을 쓴다. 원본 모델 점수는 참고가 될 뿐이다
무엇보다 내가 실제로 쓰는 조건에서 재보고 싶었다. 같은 서버, 같은 설정, 같은 문제로.
구조: 답하는 모델과 채점하는 모델을 분리
핵심 구조는 이중 모델이다.
문제 ──→ [ Answer 모델 ] ──→ 답변 ──→ [ Judge ] ──→ 점수
          로컬 vLLM 서버              기계 검증 우선
          또는 CLI 도구                안 되면 CLI Judge
Answer 모델은 두 가지 방식으로 붙인다.
api모드 — 로컬 vLLM 등 OpenAI 호환 서버의/v1/chat/completionscli모드 — codex, claude, gemini 같은 CLI 도구를 subprocess 로 실행
이 두 모드를 같이 지원하는 게 중요했다. 로컬 모델과 상용 CLI 도구를 같은 문제로 비교할 수 있어야 “이 작업을 로컬로 내려도 되나”를 판단할 수 있다.
Judge는 채점을 담당한다. 여기에 규칙을 하나 뒀다.
기계로 검증할 수 있으면 기계가 한다. 안 되는 것만 LLM 이 채점한다.
계산 결과, JSON 스키마 준수, 특정 값 포함 여부 같은 건 코드로 확인할 수 있다. 이런 걸 LLM에게 맡기면 채점 자체가 흔들린다. 채점이 흔들리면 그 벤치마크는 아무것도 측정하지 못한다.
Judge를 CLI 모드만 허용한 이유
Judge는 CLI 모드만 쓰게 막아뒀다. API Judge는 아예 지원하지 않는다.
로컬 모델이 로컬 모델을 채점하면 문제가 생긴다. 채점자와 응시자가 같은 수준이면 응시자가 틀렸는지 채점자가 못 알아본 건지 구분되지 않는다. 특히 어려운 문제일수록 그렇다.
그래서 채점은 더 강한 모델에게 맡긴다. 정답 기준도 같은 원칙으로 정했다.
Pro 답 = 정답. 의심되면 Pro 3회 만장일치.
한 번 물어봐서 나온 답을 정답으로 박으면 그 자체가 오류의 원인이 된다. 애매한 문제는 같은 질문을 세 번 던져서 답이 갈리지 않을 때만 정답으로 확정한다.
문제군을 6개로 나눴다
한 종류 문제만으로는 모델을 판단할 수 없다. 그래서 성격이 다른 6개 군으로 나눴다.
| 문제군 | 측정하는 것 |
|---|---|
korean |
한국어 이해·생성 |
agent |
도구 호출, 다단계 작업 수행 |
coding |
코드 작성과 계산 |
instruction-hierarchy |
상충하는 지시가 있을 때 우선순위 판단 |
long-context |
긴 입력에서 필요한 정보 찾기 |
structured-io |
요구된 출력 형식 준수 |
특히 agent 군은 텍스트 정확도가 아니라 실행 능력을 본다. 도구 호출이 실패했을 때 복구하는지, 금지한 명령을 쓰지 않는지, 제한 시간 안에 끝내는지 같은 것들이다.
가장 많은 시간을 쓴 부분: 측정 오류 걷어내기
여기가 예상 밖이었다. 평가 시스템에서 손이 제일 많이 간 건 채점 로직이 아니라 토큰 예산 조정이었다.
증상은 이렇다. 모델이 문제를 정상적으로 풀고 있는데 토큰 상한에 걸려서 중간에 끊긴다. 그러면 채점에서 0점이 된다. 그런데 이건 모델이 못한 게 아니라 내가 예산을 적게 준 것이다.
이걸 방치하면 추론을 길게 하는 모델이 부당하게 낮은 점수를 받는다. thinking 모드를 켠 모델일수록 손해다.
그래서 로그를 뒤져 “정상 풀이 중 상한에 닿은” 문항을 찾아내고, 그 문제군의 상한을 올리는 작업을 반복했다. 실제 조정 이력의 일부다.
- 120문항 전수 실행에서 20문항이 상한에 닿음 → 문제군별 상한을 2배로
- 재실행에서 한국어 문제 2개가 다시 49K를 정확히 소진 → 98K로
- 코딩 문제 하나가 196K를 소진 → 245,760 으로 (서버 컨텍스트에서 프롬프트용 16K를 남긴 값)
벤치마크를 만들 때 진짜 어려운 건 문제를 만드는 게 아니라, 측정하려는 것 외의 요인을 걷어내는 일이었다.
결과: VRAM 대비 효율이 드러났다
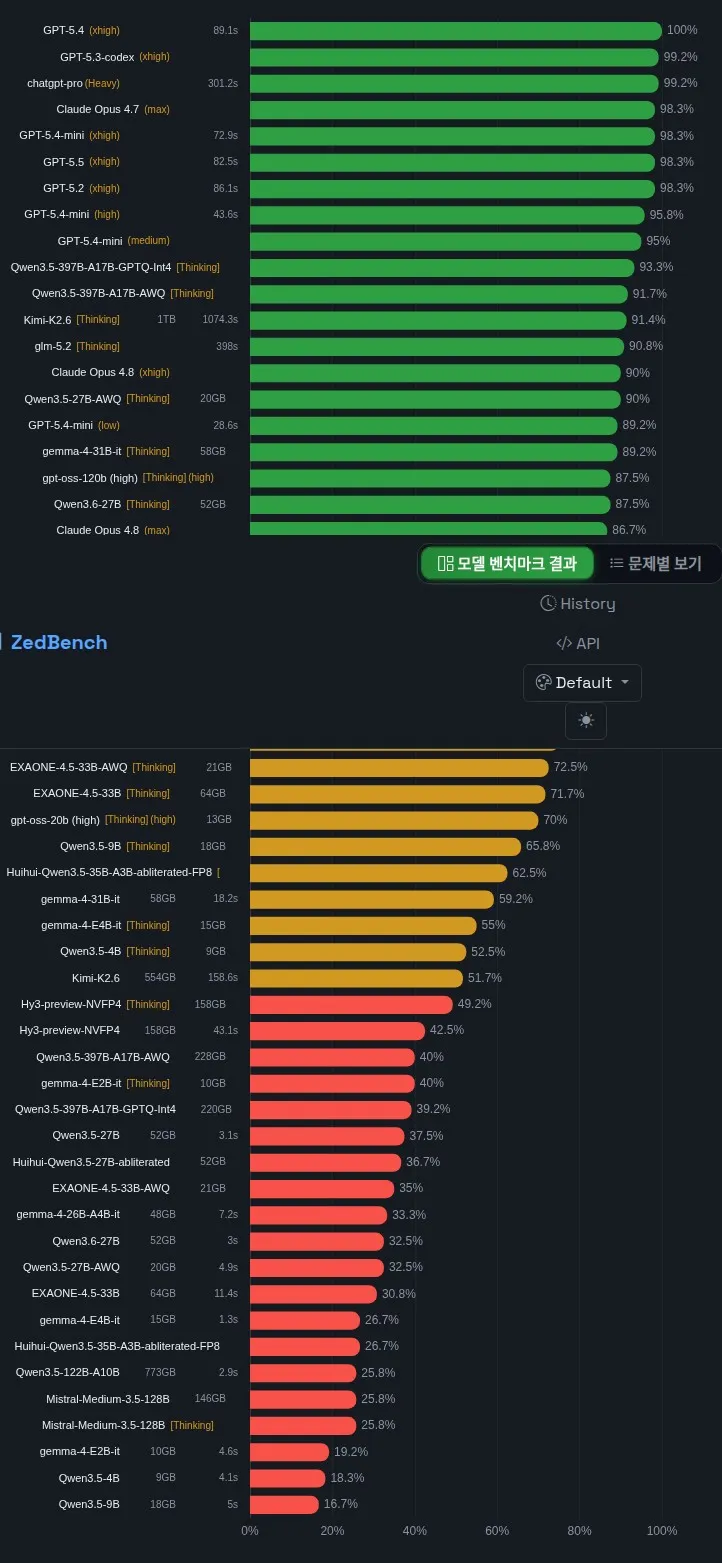
각 모델 옆에 VRAM 사용량과 응답 시간을 함께 표시하게 만든 게 핵심이었다. 점수만 보면 큰 모델이 이긴다. 그런데 자원까지 같이 보면 그림이 달라진다.
몇 가지를 보자.
| 모델 | VRAM | 시간 | 점수 |
|---|---|---|---|
| Kimi-K2.6 (Thinking) | 1TB | 1074.3s | 91.4% |
| Qwen3.5-27B-AWQ (Thinking) | 20GB | — | 90% |
| gemma-4-31B-it (Thinking) | 58GB | — | 89.2% |
| gpt-oss-120b (high) | — | — | 87.5% |
1TB를 쓰는 모델과 20GB를 쓰는 모델의 점수 차이가 1.4%p였다. VRAM 은 50배 차이인데.
시간도 마찬가지다. Kimi 는 한 세트를 도는 데 1074초가 걸린다. 상용 API 최상위권이 89초, chatgpt-pro 가 301초인 것과 비교하면 실사용에서 체감이 완전히 다르다.
이 결과로 운영을 바꿨다
원래는 큰 모델 하나를 full 로 올려서 썼다. VRAM 768GB를 갖춘 이유이기도 했다.
지금은 다르다. GPU 4장에 중간 크기 모델(27B급)을 여러 개 띄우고, 나머지 4장은 그래픽 작업에 쓴다.
이 결정의 근거가 위 데이터다.
- 점수 차이는 1.4%p — 내 용도에서 그 차이가 결과를 바꾸는 경우가 거의 없다
- 대신 응답이 10배 빠르다
- 같은 VRAM 으로 여러 인스턴스를 동시에 띄울 수 있다. 요청이 몰려도 큐가 쌓이지 않는다
- 남는 카드로 다른 종류의 작업을 돌릴 수 있다
“가장 좋은 모델”이 아니라 “내 워크로드에서 가장 쓸모 있는 배치”를 고른 셈이다. 그리고 그건 직접 재보기 전에는 알 수 없었다.
이 벤치마크의 한계
정직하게 적어둘 것들이 있다.
- 재현 불가능하다. 문제셋이 공개돼 있지 않다. 이 점수는 “내 문제셋 기준”이지 일반적인 성능 순위가 아니다
- Judge 가 LLM 이다. 기계 검증을 우선하지만 전부를 기계로 확인할 수는 없다. 채점자의 편향이 남는다
- 문제 수가 적다. 대형 벤치마크의 수천 문항에 비하면 표본이 작아 우연의 영향을 받는다
- 양자화 버전이 섞여 있다. AWQ, GPTQ-Int4, FP8 등 서로 다른 방식이 같은 표에 있다. 엄밀한 비교는 아니다
그럼에도 이 시스템이 유용한 이유는 일반적인 성능을 알려고 만든 게 아니기 때문이다. “내 서버에서, 내 문제로, 내 설정으로” 어느 쪽이 나은지만 알면 된다. 그 목적에는 충분했다.
정리
- 공개 벤치마크 순위는 내 용도와 맞는지 알려주지 않는다. 쓸 조건에서 직접 재보는 게 낫다
- 답하는 모델과 채점하는 모델을 분리하고, 기계로 검증 가능한 건 기계에게 맡긴다
- 채점자가 응시자보다 약하면 틀린 건지 못 알아본 건지 구분되지 않는다
- 정답은 한 번 물어 정하지 않는다. 애매하면 여러 번 물어 만장일치일 때만 확정한다
- 벤치마크에서 제일 어려운 건 문제 출제가 아니라 측정하려는 것 외의 요인(토큰 상한 등)을 걷어내는 일이다
- 점수 옆에 자원 사용량을 같이 표시하면 판단이 달라진다. 1TB와 20GB의 차이가 1.4%p였다
- 목표는 “가장 좋은 모델”이 아니라 “내 워크로드에서 가장 쓸모 있는 배치” 다